这是一个系列的四篇文章中的第一篇,讨论部分重配置(Partial Reconfiguration),即 Xilinx Vivado 中的动态功能交换(Dynamic Function eXchange,DFX)。本文的目的是解释这个主题的主要概念,为下一篇奠定基础;下一篇将介绍在 FPGA 工程中启用部分重配置的具体步骤。
简介
部分重配置(Partial Reconfiguration)是一种技术,它允许替换 FPGA 中某些部分的逻辑,同时让其它部分继续正常工作。实现方法是向 FPGA 送入一个比特流(bitstream),就像上电时用于对整个 FPGA 进行编程的初始比特流一样。不过,用于部分重配置的比特流不会让 FPGA 停机;它只作用于特定的逻辑单元,并更新控制这些逻辑行为的存储单元。这相当于对特定逻辑块进行热替换。
Xilinx 的 FPGA 从 Virtex-4 开始支持这一特性(Intel 的 FPGA 则从 Series-V 开始)。
本文先梳理部分重配置背后的概念,不深入动手操作的具体技术细节,目的是为下一篇做准备——下一篇正好会讲那些具体步骤。由于这个主题中所有东西都彼此相关,所以在把它拆解成一个个操作之前,先理解整个框架非常重要。
再解释一遍?
先来看在不使用部分重配置的情况下,FPGA 的功能如何改变。假设设计层次中某个模块被实例化(instantiation)了。例如在 Verilog 中:
   moduleA reconfig_ins
     (
      .clk(clk),
      .this(this_w),
      .that(that_w),
 [ ... ]
      );
或者在 VHDL 中:
  reconfig_ins : moduleA
    port map(
      clk        => clk,
      this       => this_w,
      that       => that_w,
 [ ... ]
      );
显然,工程中某处会有一个名为 moduleA.v 或 moduleA.vhd 的模块,或者一个名为 moduleA 的 IP 核(IP core),它连同其子模块一起填充了这个实例化。于是我们对该工程做一次实现,得到一个比特流文件,再用它加载 FPGA。到目前为止,这都是常规流程。
但现在假设把上面代码里的 moduleA 换成 moduleB,再对该逻辑做一次实现并得到一个比特流文件。要做到这一点,工程中必须存在 moduleB.v 或 moduleB.vhd,或者一个名为 moduleB 的 IP 核(IP core)。
现在我们有了两个比特流文件,它们只在名为 reconfig_ins 的实例内部逻辑上有所不同。要在两个比特流之间切换,需要用想要的比特流重新加载整个 FPGA,这会造成 FPGA 工作中断。
部分重配置是一种能够在这种切换过程中不中断工作的技术:FPGA 保持正常运行,同时 reconfig_ins 中的逻辑从 moduleA 变为 moduleB,也可以反向切换。几乎不用说,仅仅分别对这两个设计做实现,是实现不了这个效果的。
moduleA 和 moduleB 被称为可重构模块(Reconfigurable Module,RM),意思是借助部分重配置,可以把它们的逻辑注入 FPGA。
动机
使用部分重配置有若干理由,例如:
- 为了在不写入 flash 存储器的情况下对 FPGA 的逻辑进行远程更新(Remote Update)。例如,如果 FPGA 通过 PCIe 连接到计算机,通常希望随着主机软件的升级一起升级 FPGA 的逻辑。为了确保两边版本保持同步,很自然的一种做法是把 FPGA 比特流存放在计算机中,并通过 PCIe 接口把 FPGA 加载起来。要找到一种简便的实现方法,可以参见这个页面。
- 对于大型 FPGA,如果比特流包含了全部逻辑,加载时间可能会太长。解决办法可以是使用压缩比特流,并在初始比特流中只实现最小必需逻辑。这样 FPGA 可以很快开始工作,满足绝对必要的需求;其余逻辑在第二阶段通过部分重配置加载。这种做法通常称为串联配置(Tandem Configuration)。
- 为了复用逻辑资源来完成不同的任务,从而降低 FPGA 成本,因为同一时间并不需要所有任务同时工作。例如,如果 FPGA 用来实现多种图像滤波器中的一种,那么只有当前正在使用的滤波器会占用 FPGA 逻辑。当需要切换到另一个滤波器时,只需重载 FPGA 中分配给滤波器的区域,FPGA 的其余部分继续正常工作。
- 为了通过 JTAG 更新特定的逻辑单元,例如更新包含运行在 FPGA 上的微处理器可执行代码的块 RAM(Block RAM)。这可以带来很快的软件开发迭代周期。
- 为了把数据探针(data probe)和/或调试工具插入一个正在 FPGA 上运行的设计中。部分重配置尤其适用于这样一类问题:它们在设计的各次实现之间时有时无(这通常意味着设计在时钟、时序等方面存在根本性缺陷,不过那是另一个话题)。
部分比特流
如果你有 FPGA 设计经验,那么你很可能已经习惯了一套简单流程:对设计源代码(以及 IP 核)做一些修改,启动实现工具,检查是否顺利通过,然后通过 JTAG 把比特流加载进 FPGA;或者把一个比特流镜像烧写进 flash 器件。
因为我们都习惯了这套流程,所以很容易把比特流误认为只是一大堆数据,用某种神秘信息填满整个 FPGA,告诉每个逻辑单元应该如何工作。实际上,比特流由一串命令组成,FPGA 在加载时依次执行这些命令。诚然,普通比特流确实会用信息加载整个 FPGA,但这个过程是由多条命令完成的,这些命令控制着加载流程的推进。更重要的是,这些命令还决定每一段数据会写到哪些逻辑单元上。
由于比特流本身会写明会影响哪些逻辑单元,因此可以制作一个只修改部分逻辑单元、同时保持其它逻辑单元原封不动的比特流。这就是部分重配置的基石。
话虽如此,部分比特流必须与 FPGA 中已经加载的逻辑兼容。这里不只是“别覆盖错误的逻辑单元”那么简单:初始比特流与部分比特流是紧密耦合的,尤其是因为初始比特流会使用位于部分比特流将要改变的区域内部的逻辑和布线资源。当部分比特流相对于初始比特流被正确设置时,这种精细的配合会无声无息地进行;如果设置不当,FPGA 很可能会行为失控,连本应保持原样的功能也会一起遭殃。
加载部分比特流
只要加载过程能在 FPGA 运行期间进行,任何能够加载比特流的接口都可以用来向 FPGA 输送部分重配置比特流。JTAG 接口当然包括在内,因此可以像平常一样用 Hardware Manager 加载用于部分配置的 .bit 文件。更有意思的是,还可以在 FPGA 自身的逻辑内部完成这件事,方法是使用专用的内部配置访问端口(Internal Configuration Access Port,ICAP)。这个端口只能用于部分重配置,因为 FPGA 逻辑阵列中负责加载比特流的那部分逻辑,在整个过程中必须保持完好。
ICAP 只是通向 FPGA 比特流加载子系统的一个接口,它并不限制比特流来自哪里。因此,比特流数据如何到达 FPGA、在什么地方以及以什么方式存储,都没有限制;只要能以某种方式提供给驱动 ICAP 的那部分 FPGA 逻辑即可。
例如,如果开发板带有 PCIe 或 USB 3.x 接口,Xillybus 提供了一种简单方法,用于从计算机经由该接口向 ICAP 发送比特流文件。
静态逻辑
要把部分重配置做好,还必须重视与之相对的另一个部分:静态逻辑(static logic)。这是一个总称,指 FPGA 设计中必须保持不变的部分,因此它们从初始比特流加载时起就一直存在。
这种逻辑在两个方面是“静态”的:功能方面,指 FPGA 设计(HDL 和 IP 核)中那些从 FPGA 一开始运行就持续工作、不会中断的部分;第二个方面同样重要,即这些逻辑的布局只能位于逻辑阵列中被划作静态的位置上,这些位置以后不允许再做任何改动。
在实际设计中,仅仅让静态逻辑保持不变还不够,还要让它在 FPGA 其它部分发生变化时继续正常工作。由于几乎必然存在连接静态逻辑与待变逻辑的连线(net),保证一切正常运行是 FPGA 设计师的责任。本系列的第三篇文章会讨论这个问题。
静态逻辑与可重构逻辑的分离
即使要让部分重配置成为可能,静态逻辑与可重构逻辑(reconfigurable logic)之间也必须有严格的分离。特别是,FPGA 上的物理逻辑单元必须隔开,使得加载比特流时,任何包含静态逻辑的位置都不会受到影响。
要理解这意味着什么,先来看看我们习以为常的做法。
回想一下,普通 FPGA 实现流程是从对 HDL 设计做综合(synthesis)开始的。注意,HDL 中的模块实例化(instantiation)本身并不表示它们需要彼此分离。恰恰相反:综合器(synthesizer)把实例化看成对逻辑应如何工作的描述,因此它可以自由地把整个设计看作一大片扁平的逻辑。跨越模块边界的优化不仅被允许,而且是人们希望发生、并且经常发生的。例如,如果模块 X 中的某个寄存器恰好与模块 Y 中某个完全无关的寄存器等价,综合器就会删除其中一个,让两个模块共用剩下的那个寄存器(除非明确告诉综合器不要这样做)。
HDL 综合完成之后,综合出来的网表(netlist)会与设计中 IP 核(如果有的话)的网表合并在一起。
接下来,这一大堆逻辑单元会被放到 FPGA 逻辑阵列的各个位置,并对连线做布线,以满足时序约束(timing constraints)以及其它目标。设计中不同部分的逻辑可能被塞进同一个 slice,也可能被放到 FPGA 的两端。设计中哪怕最微小的改动,都可能让布局发生戏剧性的变化。这种结果看起来很混乱,但并无害处,因为每次实现都是相互独立的——谁会在乎逻辑是怎样散布在 FPGA 逻辑阵列上的呢?
回到部分重配置:如上所述,要让这个特性成为可能,静态逻辑和可重构逻辑之间必须有明确的区分。为了保证这一点,会用到一种称为层次化设计(Hierarchical Design)的技术。其思想是把整个设计看作一组组件,就像 PCB 上的一个个物理元件。一方面,每个组件(也就是被实例化的模块)都被分配到逻辑阵列上的某个区域;另一方面,既然每个组件都需要单独处理,显然也应该对它单独进行综合——正如你本来就会单独生产这个元件一样。
现在把这个概念与部分重配置联系起来。可以归结为设计工作中的两个主要不同点:
- 布局规划(floorplanning):FPGA 设计师必须明确地给可重构逻辑分配 FPGA 逻辑阵列中的物理区域。这个区域称为可重构分区(reconfigurable partition)。其余部分则放置静态逻辑。
- 综合(synthesis):可重构逻辑(以及可能相关的 IP 核)的综合与静态逻辑分开进行。因此,可重构逻辑与静态逻辑会得到各自独立的网表。
Pblock
Vivado 把这种布局规划单元称为 Pblock,它其实只是 Vivado 内部的一个信息占位符。可以通过 Tcl 函数创建一个 Pblock,向其中添加逻辑单元,然后再把若干组 FPGA 逻辑位置加进去。Vivado 会把它解释成一条布局约束:加入该 Pblock 的逻辑单元只能放在分配给它的位置上。所以归根结底,Pblock 与 XDC 文件中的其它约束是一样的。
Pblock 通常通过 Vivado 的图形界面来定义:打开综合后的设计或实现后的设计,在 FPGA 的图形表示上画出矩形区域。这会生成一个 Pblock,把所画矩形内的所有逻辑单元都包含进来。更准确地说,并不是所有类型的逻辑单元都会被包含,只有那些允许用于布局规划的逻辑类型(针对该 FPGA 系列)才会被包含。也就是说,Vivado 会把矩形转换成逻辑单元的范围。
直接编辑 XDC 文件来手动设置这些范围也同样可行。另外,一个区域可以包含多个矩形,所以形状可以比单一矩形更复杂。不过 Xilinx 的文档(UG909)建议尽量保持形状简单,以避免布线困难。
下面是一个针对 Kintex-7 的 XDC 文件示例:
create_pblock pblock_pr_block_ins
add_cells_to_pblock [get_pblocks pblock_pr_block_ins] [get_cells -quiet [list pr_block_ins]]
resize_pblock [get_pblocks pblock_pr_block_ins] -add {SLICE_X118Y0:SLICE_X153Y99 SLICE_X118Y250:SLICE_X145Y349 SLICE_X0Y0:SLICE_X117Y349}
resize_pblock [get_pblocks pblock_pr_block_ins] -add {DSP48_X5Y100:DSP48_X5Y139 DSP48_X5Y0:DSP48_X5Y39 DSP48_X0Y0:DSP48_X4Y139}
resize_pblock [get_pblocks pblock_pr_block_ins] -add {RAMB18_X4Y0:RAMB18_X6Y39 RAMB18_X4Y100:RAMB18_X5Y139 RAMB18_X0Y0:RAMB18_X3Y139}
resize_pblock [get_pblocks pblock_pr_block_ins] -add {RAMB36_X4Y0:RAMB36_X6Y19 RAMB36_X4Y50:RAMB36_X5Y69 RAMB36_X0Y0:RAMB36_X3Y69}
下图显示了它在实现后设计中的样子。名为 pblock_pr_block_ins 的可重构分区(在这个示例里几乎不含逻辑)以紫色绘制。它的形状是三个矩形的并集(也就是上面每条 resize_pblock 命令中列出的三个范围)。
在这张图中,所有已布置的逻辑都以青色绘制。其中绝大多数属于静态区域,可以明显看到它们被限制在一个很小的范围内。
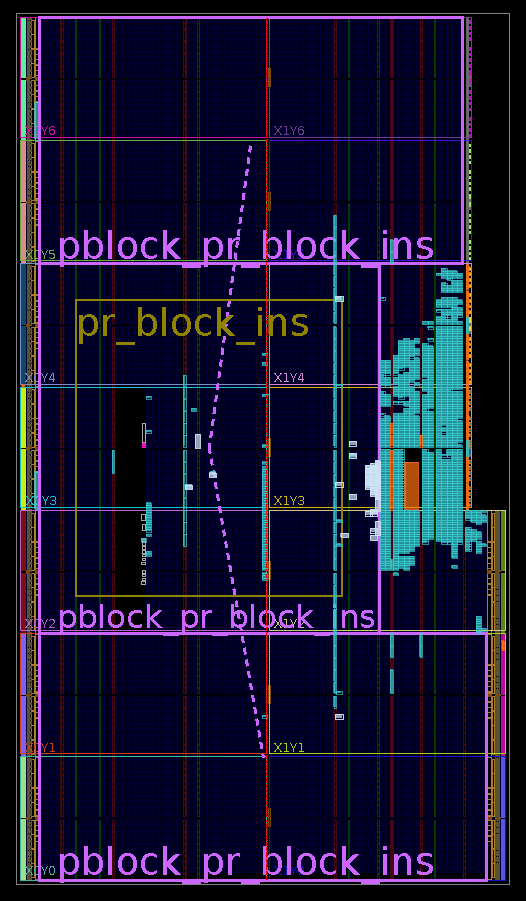
注意,只有 slice、RAM 和 DSP48 会受到这些约束的限制。对于 7 系列 FPGA,部分重配置能够控制的也只有这几种逻辑类型。除此之外的一切——实际上也就是除“纯逻辑”以外的任何资源——都必须属于静态设计。
从 UltraScale FPGA 及之后的器件开始,几乎任何逻辑都可以通过部分重配置重新加载。
Pblock 还有其它限制,但这里没有必要把 UG909 的第 6 到 8 章复述一遍。
无论如何,有空打开一个实现后的设计,在 FPGA 视图上放大缩小,观察逻辑单元在 FPGA 中如何组织,总会是一个好主意。尤其要注意,同种类型的逻辑会排成一列一列;有时候,某些列的中部会有少数逻辑单元打破这种均匀性(尤其是特殊逻辑单元,如 ICAP 块、PCIe 块等)。
值得一提的是,Pblock 这个话题并不只属于部分重配置。例如,本节讲的 Pblock 用法同样适用于用 Pblock 做层次化设计。
再多说一点布局规划
下面有几个违反直觉的事实。首先,尽管布局规划的图形表示是在 FPGA 图上画出的一些形状,但这些形状只适用于受布局约束控制的那几类逻辑。因此,即使 FPGA 上几乎所有 slice 都被划给了部分重配置,完全被这些 slice 包围起来的其它逻辑单元孤岛,也很可能属于静态逻辑。例如,ICAP 块本身恰好位于一个分配给部分重配置的矩形中间,这完全不是问题。
考虑到部分重配置比特流只指向某些逻辑单元、并让其它逻辑单元保持不变,这倒也不算太奇怪。可布线怎么办?如果一个 ICAP 块被夹在可重构逻辑中间,那么通向静态逻辑 slice 的连线是怎么布出来的?
这就引出第二个违反直觉的事实:静态设计的布线会使用可重构区域内部的资源。这些布线在整个部分重配置过程中保持稳定,否则它就不叫静态逻辑了。所以在可重构区域内部,可重构逻辑的布线会改变,但静态逻辑的布线保持不变。如果说这个主题里有任何东西让人觉得像魔法,那就是这一点。这也是为什么使用一个与静态逻辑不兼容的部分比特流,很可能会让 FPGA 彻底失控。
反过来当然不成立:除了上面 XDC 示例中明确列出的资源之外,可重构逻辑不使用任何其它资源。至于布线资源,在加载部分重配置比特流期间,静态区域不会有任何改变,所以从这个意义上说,可重构逻辑绝不会影响静态区域。嗯,这几乎是对的:如果可重构区域的形状不是一个简单矩形,Vivado 可能会让布线跑到可重构区域之外。这种情况只会发生在 UltraScale FPGA 上,目的是改善布线效果。
到这一步应该清楚的是,绘制布局规划区域的规则并不简单。好消息是,当违反布局规划规则时,Vivado 会给出信息量相当丰富的严重警告(Critical Warning)。因此,用试错的方式找到合适的布局规划,是一种可行的做法。
父实现与子实现
关于可重构逻辑的实现,有一点很重要:FPGA 中的每一条路径(path)都必须满足时序约束(timing constraints),而且在可重构逻辑加载前后都必须如此。因此,脱离静态逻辑单独实现可重构逻辑是不可能的。实际上,每次实现都是针对某个可重构模块、对整个 FPGA 进行的。时序约束以及其它约束会在每次实现中强制执行。
为了把这一点说清楚,回到上面 moduleA 和 moduleB 的例子。对这个例子而言,Vivado 会对包含 moduleA 的完整设计做一次实现,然后再对包含 moduleB 的设计做同样的事情。作为副产品,这两个方案各自会产生常规的比特流文件。
值得强调:所有实现都会产生一个完整的初始比特流,也会产生一个部分比特流。无论该实现是父实现还是子实现,这一点都成立。因此,FPGA 上电后,可以用其中任何一个初始比特流来加载它。
为了能用部分重配置从 moduleA 切换到 moduleB,静态分区中的一切都必须完全一致,包括逻辑本身、布局和布线。为了实现这一点,Vivado 会先把某一个场景(例如包含 moduleA)的实现作为父实现(Parent Implementation),然后再为所有其它场景(例如包含 moduleB)执行子实现(Child Implementation)。具体做法会在本系列的最后一篇文章中详述;长话短说如下:
Vivado 首先像普通层次化设计那样,为 moduleA 运行父实现。这意味着静态逻辑和可重构逻辑各自独立综合,而且布局规划约束把它们安排到 FPGA 上互不重叠的位置。除了这两点不同之外,其余过程与普通实现相同。特别是,布局布线(place and route)会针对这个具体场景寻求最优结果(尽管布局规划约束和分开综合本身可能会导致性能不是最优)。
下一步是为 moduleB 执行子实现。此时不再需要对静态设计做综合,因为父实现已经替它做过了;只需要对可重构逻辑做综合。
随后,子实现以与父实现相同的方式继续进行,但有一个关键差别:所有静态逻辑的布局布线都会被强制与父实现的结果完全相同。在这种限制下,工具会为可重构逻辑的布局布线寻求最优结果。
所以,父实现与子实现之间关系的关键在于:子实现从父实现结束的地方开始,但把自己的逻辑放进可重构区域,替换掉原来的可重构逻辑。之后子实现照常进行,只是不去碰静态逻辑区域中的任何东西。
因为所有子实现都必须迁就静态逻辑的布局和布线,与普通实现相比,满足时序约束可能会更难。实际上有两个障碍:
- 其一,把设计层次化地划分为静态逻辑和可重构逻辑,会阻止跨越两者边界的优化。
- 其二,静态逻辑的布局布线对可重构逻辑而言不一定是最优的。
在选择用哪一个可重构模块作为父实现时,应当把这一点记在心里。例如,可以选择最难满足时序约束的那个模块;或者选择与静态逻辑连接方式最具代表性的模块;又或者反过来,选择一个实际上完全不含逻辑的可重构模块(也就是灰盒(grey box)),以便得到一种对静态逻辑来说比较中性的实现。
至于比特流的使用,Vivado 对含部分重配置工程实现的范式是:当所有比特流都是最新并且彼此兼容时,实现才算结束。换句话说,任何一个实现产生的初始比特流都可以用于上电加载 FPGA;之后,可以加载任意一个实现产生的部分比特流。
因此,第一次 Generate Bitstream 会启动父实现以及所有子实现。在后续编译中,Vivado 照常只运行那些需要更新的实现。
Dynamic Function eXchange 向导
这个向导可以从 Tools 菜单启动,作用是定义父实现和子实现,尤其是定义哪一个实现中包含哪一个可重构模块。
要解释这个向导,最容易的方法是看它在添加一个子实现时生成的 Tcl 命令:
create_reconfig_module -name bpf -partition_def [get_partition_defs pr ]
add_files -norecurse /path/to/pr_block1.v  -of_objects [get_reconfig_modules bpf]
create_pr_configuration -name config_2 -partitions [list pr_block_ins:bpf ]
create_run child_0_impl_1 -parent_run impl_1 -pr_config config_2 -flow {Vivado Implementation 2020}
我会从下到上解释这串 Tcl 命令,也就是从最后一行开始:
最后一行创建了一个子实现运行(Child Implementation run)。这个新运行被命名为 “child_0_impl_1”,它的父运行被指定为 “impl_1”。同样重要的是,这个新运行的配置(configuration)被设为 “config_2”。
第三行定义了 “config_2”,它说明 “bpf” 是准备放进名为 “pr_block_ins” 的可重构分区的可重构模块。“pr_block_ins” 前面已经出现过,那么 “bpf” 又是什么呢?
第一行创建了一个名为 “bpf” 的可重构模块对象(reconfig_module)。这只是一个为了方便而起的名字,用来表示该模块的逻辑功能。第二行说明有一个 Verilog 文件被加入了这个可重构模块。
总的来说,这四行创建了一个新的子实现,并说明需要对某个 Verilog 文件做综合,以生成一个可重构模块。同时,Tcl 环境里还创建了两个对象:“bpf” 和 “config_2”。
回到 Dynamic Function eXchange 向导:它是一个图形界面工具,用来表达设计源文件、可重构模块、配置和实现运行之间的关系。它只是以更方便的方式录入这些信息,以便生成上面那样的 Tcl 命令。
这个工具可能看起来过于复杂,但那是因为这个例子很简单。在真实设计中,这个可重构模块很可能会包含多个源文件,还可能带有若干 IP 核。因此,图形界面会让事情更容易处理。
可为什么一定需要配置(configuration)呢?为什么不在 create_run 命令里直接建立 “bpf” 和 “pr_block_ins” 的对应关系?这又是个合理的问题,因为本文只讨论一个可重构分区。如果有多个这样的分区,配置的作用就是定义哪个分区使用哪个可重构模块,所以给每一种组合起一个 config_* 那样的名字是有道理的。
这个问题与本系列文章无关,所以你可以直接跳到下一节。
回想一下,Vivado 的实现是针对整个设计进行的,也就是把静态逻辑和可重构逻辑放在一起实现,并保证整体满足时序约束。因此,如果存在多个分区,使用部分重配置的安全做法是,用同一次实现运行所产生的部分比特流去加载所有分区。也就是说,所有部分比特流都来自同一个配置(例如 “config_2”),所以这些部分比特流的组合是经过工具验证的实现结果。特别地,可以确定该实现满足时序约束。
不过话说回来,如果各可重构模块之间没有相互交互(也就是所有可重构模块的顶层端口都连接到静态逻辑,而不是彼此相连),我想象不出把每个分区分开处理会出什么问题。诚然,如果混合使用来自不同实现运行的部分比特流,Vivado 并没有明确批准整个 FPGA 的时序。可是,既然所有与静态逻辑有关的路径都已满足时序约束,而且静态逻辑在每次实现运行中完全相同,这样难道还不够吗?官方文档似乎没有说明这个问题。
布线与分区引脚
拼图里还缺一块:连接静态逻辑与可重构逻辑的布线。回想一下,父实现会根据相关配置中所包含的可重构逻辑,用最优的方式进行整个设计的布局布线。但之后,子实现的可重构模块需要适配到同一个可重构分区中,并与静态设计连接。至少有一部分布线属于静态逻辑,因此不能改变。
这就引出了分区引脚(Partition Pins)。从概念上说,可以把可重构逻辑想象成一个物理器件,分区引脚就像是连接到 PCB 上的金属引脚。
但在现实中,分区引脚只是 FPGA 布线资源坐标系上的位置。它们是静态逻辑布线结束、可重构逻辑布线开始的地方。它们的全部意义在于,父实现和各子实现对它们的位置达成一致。
建立这些锚点不需要任何物理资源(例如 LUT 或触发器),也不会增加额外布线延迟。通往分区引脚以及从分区引脚引出的那段布线当然会产生延迟,但分区引脚本身不增加任何延迟。
分区引脚的位置会在父实现过程中由工具自动选择,子实现只能被迫去适应。换句话说,静态逻辑与可重构逻辑之间的布线从父实现所指定的地方开始,子实现只能在可重构分区内部尽最大努力。某些分区引脚可能恰好落在对子实现可重构逻辑不利的位置,从而给满足时序约束带来困难。
分区引脚通常成群地位于靠近可重构分区边界的地方。Vivado 似乎会尽量选择那些不会为某个特定设计过度定制的资源位置。
不过,如果在父实现过程中有必要满足时序约束,分区引脚也可能出现在可重构分区内部的任意位置。回想一下,静态设计被允许使用可重构分区内部的布线资源,所以有一部分静态布线进入可重构分区完全没有问题。
为了避免时序约束和分区引脚带来的麻烦,最好让可重构模块的输出端口是寄存器输出,同时它的输入也由寄存器采样。同样,静态逻辑最好也以类似的方式使用寄存器。事实上,只要条件允许,而且不会把设计变复杂,遵守这条规则总是一个好主意。
灰盒
DFX 向导中还有一样东西是灰盒(greybox)。在 Edit Configuration 窗口里,可以把灰盒指定为可重构模块,而不是某个常规的可重构模块。灰盒是 Vivado 生成的一个伪模块,它的端口与真实可重构模块一致,但里面没有真正的逻辑,而是为每个端口引脚各放一个 LUT。为输入生成的 LUT,另一端什么都没有接;为输出生成的 LUT,则输出一个常量 0。对于向量端口,向量的每一位都会创建一个 LUT。
在父实现中使用灰盒可能不是一个好主意,因为这会让布局布线过程太过轻松。即使各个可重构模块彼此差异很大,编写一个至少能在一定程度上挑战工具的简单模块,可能会更好。
不过,如果目的是生成一个包含最少逻辑的初始比特流,那么一个只含灰盒模块的子实现可能会很有用。回想一下,所有实现都会产生完整的比特流,并且都可以用作初始比特流,因为它们的静态逻辑完全相同。
清除比特流(仅限 UltraScale)
这一点只适用于 UltraScale FPGA(不包括 UltraScale+)。
如上所述,所有实现都会产生两个比特流:一个用于整个设计,可在初始加载 FPGA 时使用,其中包含对应的可重构模块;另一个部分比特流用于以同一个可重构模块进行部分重配置。
对于 UltraScale 器件,还有第三个比特流,即清除比特流(clearing bitstream),它会在每次实现时生成。这个比特流必须在部分比特流之前发送给 FPGA。注意,发送给 FPGA 的清除比特流必须与 FPGA 中当前已有的逻辑匹配,而不是与即将加载的比特流匹配。因此需要一直跟踪 FPGA 当前的状态——这一点在其它 FPGA 系列上并不是必需的。
加载清除比特流会让可重构模块关闭,尽管它实际上并没有改变逻辑。在加载并启动一个新的部分比特流之前,该模块的输出端口可能呈现任意值。
根据 UG909,如果加载了错误可重构模块的清除比特流(也就是与 FPGA 中已有逻辑不对应的清除比特流),还可能导致静态逻辑也被破坏,进而造成重配置机制失灵。
关于不先加载清除比特流、直接加载部分比特流会发生什么,Xilinx 的文档似乎语焉不详。UG909 第 9 章先说:“在加载一个新的可重构模块的部分比特流之前,必须先清除现有的可重构模块。”据此得出的结论是,清除比特流是必须的。
但同一份指南在下面几行又说:“如果不加载清除比特流文件,初始化例程(GSR)就不会生效。”这暗示,如果允许所有同步单元(原则上就是 RAM 和触发器)上电后处于未知状态,那么完全不使用清除比特流也是可以的。在我自己跳过清除比特流的零星实验里,没有看到问题,但这并不能证明什么。
所以在使用 UltraScale FPGA 时,确实需要跟踪 FPGA 中已加载的内容。一种做法是给可重构模块增加一个输出端口,让它输出一个常量值(ID 码),并且每个可重构模块的 ID 码各不相同。这样静态逻辑就能识别当前加载的是哪个可重构模块。无论如何,类似的 ID 码本身就是一个好主意。
插件式使用与远程更新
Vivado 采用的这种父-子方法论,显然是为一种特定的使用场景设计的,我把它称为插件式使用(plugin usage):只加载当前需要的可重构模块,而不是让 FPGA 时时包含所有可能的功能,从而降低 FPGA 成本。例如,如果 FPGA 用来实现若干种图像滤波器,部分重配置允许把每种滤波器实现成一个可重构模块,并且只把当前需要的那个滤波器加载到 FPGA 中。
Xilinx 用 Dynamic Function eXchange(DFX)来称呼部分配置,这似乎反映出这项技术首要的预期用途。
当部分重配置的目的是如此时,父-子方法会工作得很好。工具会生成一整套比特流文件。其中任何一个初始比特流都可以用来初始化 FPGA,之后也可以使用任何一个重配置比特流进行部分重配置。当项目发布新版本时,由所有比特流文件组成的整套文件会一起被替换。
但还有另一种使用模式,我称之为远程更新(Remote Update)。在这种模式下,部分重配置被用作以后版本升级的手段,而且可能在很久以后才进行升级。在这种使用场景中,初始比特流在某个时刻发布,之后不能再修改;再往后才发布部分比特流,而这些部分比特流必须与初始比特流兼容。后续发布可能会持续好几年。
对于远程更新,父-子方法按原样使用可能会很难办。即使可以不重新运行父实现,而直接运行子实现来得到新的部分比特流,要在很长一段时间内保持这种做法也可能很困难。例如,静态逻辑源代码一旦发生意外改动,父设计就失效了,于是必须重新运行父实现。结果,新的静态逻辑与原来的不再兼容,因此基于它产生的部分比特流无法配合最初的初始比特流使用。
所以,如果打算把部分重配置用作一种随时间为 FPGA 设计持续升级的方法,就需要对实现流程做一些处理。这个话题会在本系列的最后一篇文章中讨论。
压缩比特流
这并不直接与部分重配置相关,但有时确实希望初始比特流文件尽量小,尤其是为了确保 FPGA 能快速启动。在这种背景下,部分重配置就成了一种手段:先快速启动,再继续完成后续的上电引导过程。后续数据可以来自同一个数据源(例如 SPI flash),也可以来自完全不同的数据源(例如 PCIe 接口)。
压缩比特流对初始比特流和部分比特流都是允许的。
要请求生成压缩比特流,在 XDC 文件中加入下面这一行即可:
set_property bitstream.general.compress true [current_design]
到这里,理论部分就结束了。下一篇将给出配置一个支持部分重配置工程的具体步骤。