本页是介绍多吉比特收发器(MGT)的系列文章中的第四篇。前面几页讨论了 MGT、与之配合使用的几种协议,以及几种编码方法。
简介
正如本系列第一页中已经提到的,MGT 不过是一种复杂的 SERDES。它之所以做得这么复杂,原因之一是 MGT 内部有一些用于实现特定协议的功能模块。本页将解释其中一些功能模块背后的设计思路。
MGT 中包含这些单元的部分通常称为 PCS(Physical Coding Sublayer,物理编码子层)。这个名称有一定误导性,因为 PCS 内的某些逻辑与编码和解码完全无关。
下面这个框图展示了一个典型 MGT 的结构,以及 PCS 在整体中的位置。
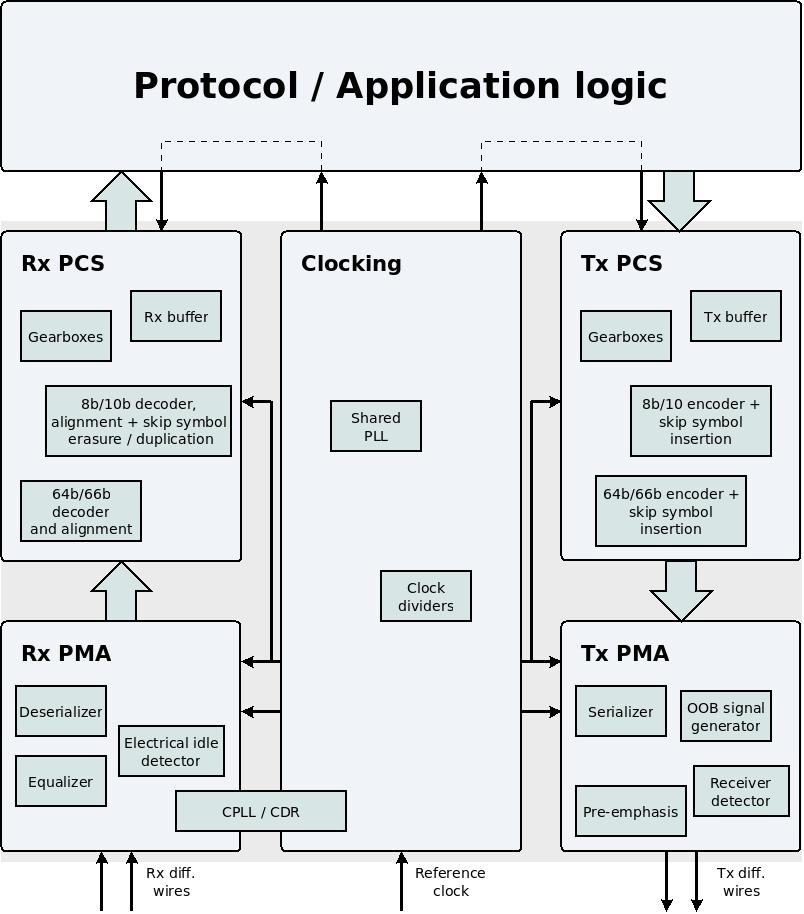
PCS 包含从 PMA 到用户应用逻辑之间的所有部分。我将用 Tx PMA 和 Tx PCS 指 MGT 中用于发送数据的部分;类似地,用 Rx PMA 和 Rx PCS 指用于接收数据的部分。
Tx PCS 从应用逻辑把待发送数据交给 MGT 的输入端口开始,到形成一个准备好发送到物理导线上的并行字为止。这个并行字会被交给 Tx PMA,由它完成串行化和电信号转换。
类似地,Rx PCS 从 Rx PMA 完成接收和解串后的并行数据字开始,到 MGT 把数据交给应用逻辑的输出端口为止。
由于 PCS 内部只是对并行字进行处理的逻辑,因此 PCS 的全部功能都可以在逻辑结构(logic fabric)中实现。尽管如此,这些逻辑仍然被放在 MGT 内部实现,这与许多功能模块被做成硬 IP(hard IP)的原因相同。有些协议会利用 PCS 的编码能力;另一些协议(例如 xillyp2p)则依赖自己的数据流处理方法,这让 MGT 的使用简单得多,如这个设计示例所示。
由于不同 MGT 的内部结构各不相同,不可能以一种覆盖所有 MGT 的方式来描述 MGT PCS 内部的数据流向。因此,下面的描述和解释着重说明 PCS 中各功能模块的用途。要了解具体 MGT 的 PCS 及其内部模块的详细说明,只能查阅该 MGT 自己的文档。希望借助下面的解释,读者阅读这些文档会容易一些。
编码与解码
在上一页中介绍了几种编码方法:8b/10b、64b/66b、64b/67b、128b/130b 和 128b/132b。
所有 FPGA MGT 的 PCS 内部都包含 8b/10b 的实现。它既包括把 8 位字编成 10 位字以及反向解码,也包括上一页提到的其他功能:K 符号、收到逗号符号(K28.5)后的同步与对齐(alignment),以及处理跳过符号(K28.0)。
至于其他编码方法,不同 MGT 实现的内容各不相同。不同 MGT 对各种编码特性的支持程度也不一样。有时 MGT 的 PCS 只实现必要的齿轮箱,有时还带有自动同步机制。并没有一套统一的标准功能集合。
齿轮箱
在 PCS 内部以及与应用逻辑的接口中,物理信道上的数据流始终以并行字的形式表示。当数据在 PCS 内部经过不同处理步骤时,这个并行字的位宽可能发生变化。例如,当数据通过 8b/10b 编码器时,字宽会从 8 位变成 10 位。
不过,MGT 用来接收和发送应用数据的接口,其输入和输出端口的位宽始终是 8 的倍数。典型位宽为 16、32、40、64、80、128 或 160 位。
但如果使用 64b/66b 编码会怎样呢?在这种编码中,物理信道上的数据流由许多 66 位长的段组成。如果用一个 64 位宽的并行字来表示这些数据,那么每个 66 位段的起始位置在这个字中会每次都不同。即使采用接口允许的其他位宽,也无法避免这个问题。
这正是齿轮箱(gearbox)的作用。齿轮箱是一个逻辑模块,它能把到达其输入端口的并行数据重新组织成另一种位宽的并行字。
例如,我们想借助 MGT 传输已经用 64b/66b 编码过的数据,而编码器由应用逻辑实现。编码器的输出位宽为 66 位,但 MGT 的输入位宽只能是 64 或 80 位(或其他更不常用的可选值)。为了解决这个问题,就必须实现一个齿轮箱,把现有的 66 位宽并行字重新组织成 MGT 能够接受的 64 位宽字。这种局面最好能避免。
因此,MGT 的 PCS 部分往往带有一个或多个齿轮箱。尤其是当 MGT 内置了 64b/66b 编码器(或类似的编码器,如 128b/130b)时,MGT 内部也会有配套的齿轮箱。这样,MGT 就能处理编码数据传输所需的全部任务:首先用 MGT 的编码器对数据进行编码,然后由齿轮箱改变并行字的位宽,最后把它交给 Tx PMA 部分进行发送。接收数据时也有类似的方案。
由于齿轮箱两侧的字宽不同,进入齿轮箱的比特数与从齿轮箱输出的比特数也不相等。如果输入端的并行字更宽,齿轮箱就必须偶尔拒绝接收一个输入字来补偿差异。反过来,如果输出端的并行字更宽,齿轮箱的输出端口就不会总保持有效数据。因此,如果齿轮箱只使用一个时钟,就必须有一个流量控制(flow control)信号来补偿两侧比特数量的差异。在 Xilinx / AMD 的术语中,这称为同步齿轮箱(synchronous gearbox)。
另一种方案是让齿轮箱依赖两个时钟。这两个时钟的频率经过选择,使得它们能补偿齿轮箱两侧字宽的比率。这种方法的优点是齿轮箱两侧的数据流永远不必停下来。但这种齿轮箱需要两个时钟,并且在两个时钟域(clock domain)中工作。这种方案称为异步齿轮箱(asynchronous gearbox)。
Tx 缓冲器(Tx FIFO)
Tx 缓冲器(通常称为 Tx FIFO)是位于 Tx PCS 内部的一个小型 FIFO。这个 FIFO 的深度通常为 16 或 32 个数据元素,正常工作条件下大约处于半满状态。为什么需要这个 FIFO,原因比较曲折,下文将作解释。不过,这些解释并不能回答配置 MGT 时通常唯一需要关心的问题:Tx 缓冲器到底要不要使能?
答案是:在大多数情况下,Tx 缓冲器应当使能。不用 Tx 缓冲器的唯一理由是它引入的延迟会带来问题:使用 Tx 缓冲器意味着,从一个并行字被交给 MGT 到该字真正在物理层上被发送出去,两者之间存在一个不确定的延迟。在大多数应用中,这意味着约 0.1 μs 或更短的不确定性,因此协议并不在乎这个延迟。
至于为什么需要这个 FIFO,解释如下。
Tx PCS 内部至少有两个时钟域。第一个时钟用于与应用逻辑接口;第二个时钟(有时称为 XCLK)用于 Tx PCS 把并行字交给 Tx PMA 进行发送的位置。
MGT 内部的时钟问题在另一页中单独讨论。这里只需要理解为什么必须有两个彼此独立的时钟。为了说明这一点,我们把 MGT 与普通 SERDES 作个比较。
例如,假设我们想借助一个普通输出引脚以 1000 Mbit/s 的速率发送数据。如今大多数 FPGA 的每个输出引脚旁都配有 SERDES,正好用于这一目的。在这个例子中,假设应用逻辑送给 SERDES 的并行字是 8 位宽。那么这个并行字对应的时钟频率就是 125 MHz。
因此,SERDES 需要两个时钟:一个 125 MHz 时钟,一个 500 MHz 时钟。SERDES 使用 500 MHz 时钟的两个边沿,因此数据按所需的 1000 Mbit/s 速率发送。
SERDES 得到的两个时钟必须对齐。例如,500 MHz 时钟的上升沿必须与 125 MHz 时钟的上升沿同时出现。这是 SERDES 正常工作的必要条件。这种对齐可由同一个 PLL 产生两个时钟,并使用具有相同传播延迟(propagation delay)的时钟缓冲器来实现。这是保证时钟对齐的常用方法,参见关于相关时钟(related clocks)的说明。
但如果我们想以 5000 Mbit/s 的速率发送呢?普通输出引脚无法承受这么高的速率,因此就需要 MGT。MGT 内部也包含一个 SERDES。假设送到这个 SERDES 的并行字宽度为 32 位,那么该字对应的时钟频率为 156.25 MHz。再假设 MGT 与应用逻辑之间的接口也是 32 位宽,因此这个接口的时钟频率同样是 156.25 MHz。但是,这是不是同一个时钟信号呢?
为了发送这个并行字,MGT 内的 SERDES 必须有一个 2500 MHz 的时钟(在时钟的两个边沿各发送一个新位)。对 FPGA 的通用 PLL 来说,这个频率太高了。也不可能使用 FPGA 的时钟缓冲器或其他布线资源来传递这个时钟。因此,MGT 必须自带 PLL 和内部走线,用于产生 SERDES 所需的那两个彼此对齐的时钟。更详细的讨论见关于 MGT 时钟的页面。
现在我们就能理解为什么 Tx PCS 内部至少有两个时钟域了。在这个例子中,Tx PCS 给 Tx PMA 送去的并行字为 32 位宽。这个字的时钟频率是 156.25 MHz,由 MGT 的 PLL 产生,以保证它与 2500 MHz 时钟对齐。应用逻辑与 MGT 之间的接口使用的频率完全相同,但应用逻辑却不能直接使用同一个时钟信号:应用逻辑的时钟必须经过逻辑结构的时钟缓冲器,以便到达所有逻辑单元时没有时钟偏斜(clock skew)。由于该时钟缓冲器存在延迟,应用逻辑的时钟并非天然地与 2500 MHz 时钟对齐。
实现跨时钟域(clock domain crossing)最直接的办法是使用 FIFO(如讨论该主题的页面所述)。Tx 缓冲器就是这个 FIFO。
对于那些允许绕过 Tx 缓冲器的 MGT,它们还提供了其他方法来确保 Tx PCS 内部各时钟之间必要的对齐。但这些方法实现起来复杂,而且容易出错。
Rx 缓冲器(Rx FIFO)
Rx 缓冲器(常称为 Rx FIFO)是 Rx PCS 内部的一个小型 FIFO。从原则上讲,它与 Tx 缓冲器相同,因此上面关于 Tx 缓冲器的一切论述同样适用于 Rx 缓冲器。特别是,关于这个缓冲器是否应该使能的问题,答案也一样:在大多数应用中,Rx 缓冲器应使能,除非它引入的延迟让人无法接受。
不过,Rx 缓冲器还有一个额外用途:它允许 Rx PCS 在两个频率存在微小差异的时钟下工作。下面我们将说明为什么会产生这种频率差异。
首先回顾一下,本节的讨论针对 MGT 中接收数据流的那一部分。然而,这个数据流由另一个 MGT 生成,而那个 MGT(大多数情况下)依赖另一个参考时钟。接收数据流的 MGT 通常无法获得发送端所使用的时钟。它只能根据数据流本身来重新生成该时钟的副本——这称为 CDR(Clock Data Recovery,时钟数据恢复)。
于是,Rx PMA 使用的是一个会自适应发送端数据速率的时钟。这个时钟的频率存在不确定性,但在规定的容差范围内。协议总会规定频率允许偏离标称值多少,但不确定性始终存在。
因此,从 Rx PMA 到 Rx PCS 移交并行字的接口,所依赖的是一个随发送端自适应的时钟。换句话说,Rx PCS 必须与一个外部对端时钟保持同步。
但为什么这与 Tx PCS 不同呢?回想一下关于 Tx 缓冲器的讨论:在 Tx PCS 内部有两个时钟域。虽然这两个时钟不是同一个时钟信号,但由于它们基于同一个参考时钟,因此频率完全相同。
同样,Rx PCS 内部也有两个时钟域。其中一个时钟的频率未知。另一个呢?答案是取决于应用逻辑的需要:在大多数场景下,MGT 用于实现双向协议,这种协议需要根据收到的数据来发送数据。因此,让所有应用逻辑都同步于同一个时钟会比较方便。更具体地说,最常见的做法是让所有应用逻辑都同步于用于发送的时钟。这意味着 Rx PCS 与应用逻辑之间的接口,与 Tx PCS 一样,也同步于同一个时钟。
采用这种方案时,Rx PCS 内部两个时钟的频率并不相同。结果,Rx PCS 从 Rx PMA 接收数据的速率,与它把数据交给应用逻辑的速率不一样。Rx 缓冲器可以临时吸收这种差异:如果应用逻辑取数的速率较慢,多余的暂存数据会在 Rx 缓冲器中累积;如果应用逻辑取数较快,Rx 缓冲器会被逐渐取空,直至变为 empty(空)。
这当然只能解决一时的问题。除非采取某些机制让 Rx 缓冲器的填充水平维持在约半满,否则它迟早会溢出(overflow)或变为 empty(空)。这种机制有几种。例如,按照上一页的说明,如果使用 8b/10b 编码,可以插入跳过符号来补偿时钟频率差异。利用跳过符号的机制就实现于 Rx PCS 内部:如果 Rx 缓冲器的填充水平超过半满,Rx PCS 就不把跳过符号写入 Rx 缓冲器,从而降低填充水平。反过来,如果填充水平低于半满,Rx PCS 就会反复从 Rx 缓冲器读取跳过符号。这样,新数据在填充缓冲器的同时,缓冲器却没有被排空,于是填充水平就会上升。
由于 Rx 缓冲器能临时吸收其填充水平的差异,它常被称为弹性缓冲器(elastic buffer)。需要注意,这种能力并非在所有情况下都需要:如果应用逻辑使用与 Rx PMA 时钟同频的时钟来与 Rx PCS 接口,Rx 缓冲器的行为实际上与 Tx 缓冲器相同。采用这种做法时,如果需要跨时钟域,就由应用逻辑来负责实现。这种做法也允许在必要时禁用 Rx 缓冲器(尤其是为了规避延迟)。Xillyp2p 就是一个实例:它的应用逻辑使用 Rx PMA 的时钟接收数据,但也允许使用 Rx 缓冲器来简化时钟处理。
与伪随机序列有关的功能
伪随机比特序列(pseudo-random bit sequence,PRBS)是一种看起来是随机的比特序列,但它并不是真正随机:PRBS 会按周期重复自身。由于很容易产生周期非常长(数百万比特)的 PRBS,其统计特性与真正随机比特序列很接近。
产生 PRBS 最常见的方法是使用线性反馈移位寄存器(Linear-Feedback Shift Register,LFSR)。这种逻辑只包含少量触发器和异或门,因此实现 LFSR 所需资源很少。一个常用 LFSR 的例子见独立页面,该页讨论了与 LFSR 相关的一个数学话题。
MGT 的 PCS 部分通常带有一些与 PRBS 相关的功能。例如,MGT 可能内置了加扰器(scrambler)的实现。如果接收端 PCS 还实现了加扰器的同步机制,就能省去大量工作。
PRBS 另一个非常常见的用途是对物理信道进行差错测试。这是一种很有用的方法,因为接收端可以借助 LFSR 轻松产生正确的比特序列。把本地产生的比特序列与到达的数据流进行比较,就可以检测物理信道上的错误。这个机制在逻辑结构中实现并不难,但仍有一些 MGT 把它内置了。
遗憾的是,在进行 PRBS 差错测试期间,物理信道不能同时用于正常数据发送。因此,无法在信道实际工作时持续监测其质量。有些协议提供了差错上报机制,但通常只有错误破坏了已发送的数据时才会上报。一个例外是 xillyp2p:即使链路处于空闲状态时出现错误,它也会上报。
至此,关于 MGT 的本系列第四页就结束了。下一页将开始讨论 PMA,以及它在补偿不良物理信道方面的能力,还有执行眼图扫描(eye scanning)的能力。