概述
本页是关于 FIFO 的系列教程中的最后一页,将展示如何把一个现有 FIFO 改造成另一种 FIFO:首先是把“标准 FIFO”转换为 FWFT FIFO,然后再反过来。之后,还会介绍一些更高级的方法来改善 FIFO 的时序(timing),也就是让它能在更高的时钟频率下工作。
从实用的角度来看,除非你在满足时序约束(timing constraints)方面遇到了问题,而且这个问题与 FIFO 相关,否则通读本页的意义不大。本页的内容有一定难度,对于 FIFO 的日常使用也不是必需的。不过,把它当成一次练习仍然是值得的,可以借此磨炼你设计逻辑(尤其是处理数据的逻辑)时需要用到的那身功夫。
另有一个页面与这里的内容没有直接关系,它展示了如何借助外部存储器实现一个非常深的 FIFO(通常是 DDR 存储器,不过任何带有 AXI 接口的存储器都可以)。这个技巧的妙处在于:尽管这个巨型 FIFO 的深度可以做到与它使用的外部存储器一样深,但对应用逻辑来说这一切都是透明的——它仍然具有和基线 FIFO 相同的接口。
顺便提一下,本页上的 Verilog 代码是我很多年前写的,所以编码风格与现在略有不同。
把标准 FIFO 改造成 FWFT FIFO
先快速回顾一下前面介绍的 FWFT FIFO:对于“标准 FIFO”而言,@empty(空)端口为低意味着:在时钟上升沿 @rd_en 为高之后,FIFO 的输出端口上会出现有效数据。而 FWFT FIFO 会在数据就绪时立刻把它送到输出端口上,所以 @empty(空)信号为低直接表示输出端口上的数据是有效的。
@rd_en 的含义也不同:对于“标准 FIFO”,它表示“给我数据”;而在 FWFT FIFO 上,它更像是“我刚消费完这个数据,如果你有下一个数据,就送来吧”。
下面这个模块可以把“标准 FIFO”转换为 FWFT FIFO。不出所料,它只是对 @rd_en 和 @empty(空)做了一些处理,其余信号都直接透传。
module basic_fwft_fifo(rst,
                       rd_clk, rd_en, dout, empty,
                       wr_clk, wr_en, din, full);

   parameter width = 8;

   input                 rst;
   input                 rd_clk;
   input                 rd_en;
   input                 wr_clk;
   input                 wr_en;
   input [(width-1):0]   din;
   output                empty;
   output                full;
   output [(width-1):0]  dout;

   reg                   dout_valid;
   wire                  fifo_rd_en, fifo_empty;

   // orig_fifo is just a normal (non-FWFT) synchronous or asynchronous FIFO
   fifo orig_fifo
      (
       .rst(rst),
       .rd_clk(rd_clk),
       .rd_en(fifo_rd_en),
       .dout(dout),
       .empty(fifo_empty),
       .wr_clk(wr_clk),
       .wr_en(wr_en),
       .din(din),
       .full(full)
       );

   assign fifo_rd_en = !fifo_empty && (!dout_valid || rd_en);
   assign empty = !dout_valid;

   always @(posedge rd_clk or posedge rst)
      if (rst)
         dout_valid <= 0;
      else
         begin
            if (fifo_rd_en)
               dout_valid <= 1;
            else if (rd_en)
               dout_valid <= 0;
         end
endmodule
在这里,我本来会照例对这段代码作一番解释,但那只会重复上一页中已经给出的 FWFT FIFO 说明。
把 FWFT FIFO 改造成标准 FIFO
这一点很简单。既然 FWFT FIFO 的 @empty(空)为低表示输出端口上有数据,那么只需创建一个寄存器,当 @rd_en 为高时对这个数据进行采样。
于是只需要这样:
module standard_fifo(rst,
                     rd_clk, rd_en, dout, empty,
                     wr_clk, wr_en, din, full);

   parameter width = 8;

   input                 rst;
   input                 rd_clk;
   input                 rd_en;
   input                 wr_clk;
   input                 wr_en;
   input [(width-1):0]   din;
   output                empty;
   output                full;
   output [(width-1):0]  dout;

   reg [(width-1):0]     dout;
   wire [(width-1):0]    dout_w;

   always @(posedge rd_clk)
     if (rd_en && !empty)
       dout <= dout_w;

   fwft_fifo wrapper
     (
      .wr_clk(wr_clk),
      .rd_clk(rd_clk),
      .rst(rst),
      .din(din),
      .wr_en(wr_en),
      .rd_en(rd_en && !empty),
      .dout(dout_w),
      .full(full),
      .empty(empty)
      );
endmodule
注意,这里只对 @dout 做了处理。@empty(空)是原样透传的:如果它为高,@dout_w 就无效,所以 @dout 无法从它采样到有效值。
改善时序的技巧
欢迎来到这个关于 FIFO 的系列的压轴部分——这绝对是阅读起来最困难的部分。
有时候,当你在排查为什么某个 FPGA 设计无法满足时序约束(也就是达不到期望的时钟频率)时,你会发现关键路径(critical path)的起点和(或)终点落在某个 FIFO 上。我们先来看容易解决的情况,最后再啃那块硬骨头。
当 @empty(空)和(或)@full(满)处于关键路径中时
@empty(空)和 @full(满)信号可能出现在关键路径中,尤其是当 @wr_en 和 @rd_en 是它们的组合逻辑(combinatorial logic)函数时。这主要是因为,这些信号通常不仅用于向 FIFO 请求写操作或读操作,还充当着消费或产生数据的应用逻辑的使能信号:如果数据流不走了,逻辑也会跟着停摆。
因此,往往会有很多逻辑方程依赖 @wr_en 和 @rd_en,而且这些逻辑函数常常相当复杂。其结果就是很高的扇出(fan-out)。这一切最终都归结为一个麻烦的传播延迟(propagation delay)。
在任何一个编写正确的 FIFO 中,@empty(空)和 @full(满)都是触发器的输出,所以这一点本身没有太多可改善的。但由于 FPGA 厂商的软件通常以综合后的网表(netlist)形式交付 FIFO,因此很难(至少不容易)为了降低这些信号的扇出而复制这些寄存器。另外,在 FPGA 的可编程逻辑结构上,这些寄存器与使用其输出值的应用逻辑之间可能有很大的物理距离。在大规模 FPGA 上,这会成为路径延迟的主要贡献因素。
解决这个问题的方法,其实在那一页讨论 @almost_empty(几乎空)和 @almost_full(几乎满)时已经给出了。使用这些端口之后,@wr_en 和 @rd_en 的输出可以来自寄存器。这样就解决了组合逻辑函数的问题,也让这些信号的扇出可以得到控制。除此之外,它还能帮助工具把这些寄存器放置在更靠近使用其值的逻辑的位置,从而有助于减小传播延迟。
当 @wr_en 和(或)@din 处于关键路径中时
这种情况最容易解决:直接加一级寄存器就行,例如:
always @(posedge wr_clk)
  begin
    wr_en_reg <= wr_en;
    din_reg <= din;
  end
然后把 @wr_en_reg 和 @din_reg 接到 FIFO 上。为防止 FIFO 发生溢出(overflow),应当改用 @almost_full(几乎满)而不是 @full(满)。更一般地说,FIFO 开始阻止写入的阈值应该降低一个数据字。
当 @rd_en 和(或)@dout 处于关键路径中时
接下来要认真面对了。这个问题不仅解决起来相对困难,而且也是最常见的情况。原因有以下几点:
- @rd_en 信号在 FIFO 内部的组合逻辑中会被用到,例如在计算下一个读地址时就是如此。因此,FIFO 自身也会贡献一部分延迟。
- 产生 @rd_en 的应用逻辑往往是一个可能相当复杂的组合逻辑函数。这个逻辑函数可能由状态寄存器和来自可编程逻辑结构中不同位置的若干标志位组成。
至于 @dout:
- FIFO 的数据输出往往直接连接到块 RAM(block RAM)。相比 FPGA 的触发器,这类 RAM 的时钟到输出(clock-to-output)时序明显更差。如果 FIFO 由多个 RAM 实现,它们的数据输出会被送入一个多路选择器(multiplexer),所以 @dout 就成了这段组合逻辑的结果,这又增加了不少延迟。
- 应用逻辑也可能会在组合逻辑函数中使用 @dout 的值。
- 在大规模 FPGA 上,FIFO 的 RAM 与应用逻辑之间的物理距离也会增加延迟。
因此,目标就是消除从 @rd_en 到 FIFO 内部逻辑的组合逻辑路径(combinatorial path),对 @dout 也是如此。
只切断 @dout 的组合逻辑路径
我并不想把这一节当作一个正式方案来介绍,但这段讨论可能有助于你理解后面的内容,权当是理解下一步的铺垫。如果你只觉得越看越糊涂,完全可以跳过这一节。
假设我们只想切断 @dout 的组合逻辑路径。请注意,前面那个把 FWFT FIFO 转换为“标准 FIFO”的包装模块(wrapper module)做的正是这件事:它增加了一个寄存器,从而终结了 @dout 的组合逻辑路径。但这要求以 FWFT FIFO 作为出发点。
可是我们前面还有一个把“标准 FIFO”转换为 FWFT FIFO 的包装模块。那么是不是可以把 FIFO 来回转换?或者干脆写一个能完成同样事情的模块?无论怎么做,这类方案都会让 @rd_en 的情况变得更糟。
不过,这个方案还是值得仔细看一看的:转换为 FWFT FIFO 的过程,本质上是记录被包装 FIFO 的 @dout 何时有效,并在 @dout 无效(和(或)外部 @rd_en 为高)时保持 @fifo_rd_en 为高。
而转回“标准 FIFO”的做法则是:当 @rd_en 为高时,把被包装 FIFO 的 @dout 的值复制到一个寄存器里。
总而言之,第一个机制在可能的时候让被包装 FIFO 的 @dout 保持有效;第二个机制则在外部 @rd_en 提出请求时,把 @dout 复制到另一个寄存器里。
但这并不能解决 @rd_en 的组合逻辑路径问题:为了实现连续读取,外部 @rd_en 为高的每个时钟周期,都必须从原始 FIFO 中读出一个数据字。否则,FWFT 的 @dout 会因为被消费却没有更新而变成无效。因此,这个内部 FIFO 的 @rd_en 必须是外部 @rd_en 的组合逻辑函数。如果要改变这一点,就需要在 @dout 的路径上再增加一个寄存器,如下一小节所示。
用 reg_fifo 同时切断两条组合逻辑路径
闲话少说,下面就是 reg_fifo 模块,它把 @rd_en 和 @dout 的组合逻辑路径都切断了:
module reg_fifo(rst,
                rd_clk, rd_en, dout, empty,
                wr_clk, wr_en, din, full);

   parameter width = 8;

   input                 rst;
   input                 rd_clk;
   input                 rd_en;
   input                 wr_clk;
   input                 wr_en;
   input [(width-1):0]   din;
   output                empty;
   output                full;
   output [(width-1):0]  dout;

   reg                   fifo_valid, middle_valid;
   reg [(width-1):0]     dout, middle_dout;

   wire [(width-1):0]    fifo_dout;
   wire                  fifo_empty, fifo_rd_en;
   wire                  will_update_middle, will_update_dout;

   // orig_fifo is "standard" (non-FWFT) FIFO
   fifo orig_fifo
      (
       .rst(rst),
       .rd_clk(rd_clk),
       .rd_en(fifo_rd_en),
       .dout(fifo_dout),
       .empty(fifo_empty),
       .wr_clk(wr_clk),
       .wr_en(wr_en),
       .din(din),
       .full(full)
       );

   assign will_update_middle = fifo_valid && (middle_valid == will_update_dout);
   assign will_update_dout = rd_en && !empty;
   assign fifo_rd_en = !fifo_empty && !(middle_valid && fifo_valid);
   assign empty = !(fifo_valid || middle_valid);

   always @(posedge rd_clk)
      if (rst)
         begin
            fifo_valid <= 0;
            middle_valid <= 0;
            dout <= 0;
            middle_dout <= 0;
         end
      else
         begin
            if (will_update_middle)
               middle_dout <= fifo_dout;

            if (will_update_dout)
               dout <= middle_valid ? middle_dout : fifo_dout;

            if (fifo_rd_en)
               fifo_valid <= 1;
            else if (will_update_middle || will_update_dout)
               fifo_valid <= 0;

            if (will_update_middle)
               middle_valid <= 1;
            else if (will_update_dout)
               middle_valid <= 0;
         end
endmodule
首先要注意,@dout 是本模块中定义的一个寄存器,@rd_en 会引起这个寄存器的更新。不要把它与连接到内部 FIFO 的类似信号 @fifo_dout 和 @fifo_rd_en 混淆,这一点很重要。
下面来说明这个模块的工作原理。
理解这条流水线
从本质上讲,这个结构就是一个 skid buffer(防滑缓冲器):这是一条带有效标志位的两级流水线(pipeline),它把外部 @rd_en 与内部 FIFO 的读使能解耦开来,同时仍然允许数据连续流动。
与 FWFT FIFO 转换器类似,这里也实例化了(instantiation)一个普通 FIFO,即 orig_fifo。reg_fifo 模块中的逻辑会尽量让 @fifo_dout 的值保持有效:当 @fifo_dout 没有包含有效值时,就从 orig_fifo 中读出一个数据字。除此之外,这里还有第二个寄存器 @middle_dout。逻辑也尽量让这个寄存器保持有效,方法是:只要条件允许,就把 @fifo_dout 的值取过来。
因此,可以把 @fifo_dout、@middle_dout 和 @dout 看成一条流水线,它把 orig_fifo 中的数据一级一级地向前传送。
有两个寄存器用来跟踪这些流水线级何时有效:当 @fifo_dout 有效时 @fifo_valid 为高;当 @middle_dout 有效时 @middle_valid 为高。
这条流水线的目的在于允许旁路其中间级:当 @rd_en 为高(且 @empty(空)为低)时,@dout 的新值可以来自 @middle_dout,也可以来自 @fifo_dout,但它总是优先选择 @middle_dout。换句话说,如果 @middle_dout 有效,@dout 就使用 @middle_dout;否则才退而使用 @fifo_dout。这正是切断 @rd_en 组合逻辑路径的关键,稍后会加以解释。
那么先来看实现中的细节。从 FIFO 的数据输出到 reg_fifo 的输出寄存器,有两条相互独立的通路。在这幅示意图中,它们分别显示在左侧和右侧。
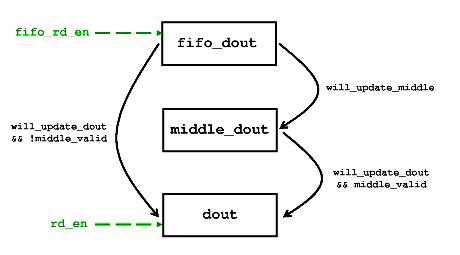
如果两级流水线(@fifo_dout 和 @middle_dout)中没有一级是有效的,@empty(空)就会为高,表示无处可取数据:
assign empty = !(fifo_valid || middle_valid);
让这些流水线级保持有效的努力体现在下面的赋值上:
assign fifo_rd_en = !fifo_empty && !(middle_valid && fifo_valid);
它的意思是:只要这两级流水线中任意一级无效,就尽量从 orig_fifo 读取数据。如果 @fifo_dout 已经有效,那么当 @fifo_dout 被更新时,它的值会同时被复制到 @middle_dout(关于这一点,下面还会详述)。
下面来看 @will_update_* 这一对信号的定义:
assign will_update_middle = fifo_valid && (middle_valid == will_update_dout);
assign will_update_dout = rd_en && !empty;
首先注意,@will_update_dout 就是 @rd_en 再加上一个安全保护:当 @empty(空)为高时禁止从 reg_fifo 读取。
接下来是 @will_update_middle,它控制着 @middle_dout 的更新:
always @(posedge rd_clk)
  if (will_update_middle)
     middle_dout <= fifo_dout;
看上面 @will_update_middle 的定义,可以看到更新 @middle_dout 需要两个条件:一个是 @fifo_dout 的值有效,这一点很明显;另一个是表达式 (middle_valid == will_update_dout)。我们把后一个表达式按四种可能的情况逐一拆解,这样就能看清整套机制的工作原理。请记住,这一切只有在 @fifo_dout 有效时才会起作用:
- @middle_valid == 0,且 @will_update_dout == 0:@middle_dout 无效,@fifo_dout 的值暂时不会复制到 @dout。因此应当用 @fifo_dout 更新 @middle_dout。
- @middle_valid == 0,且 @will_update_dout == 1:@middle_dout 无效,但 @dout 即将被更新,所以它显然会从 @fifo_dout 取值。由于 @fifo_dout 的值即将被消费,不能再复制到 @middle_dout,因此什么也不做。
- @middle_valid == 1,且 @will_update_dout == 0:@middle_dout 有效,并且没有数据被复制到 @dout。此时两级流水线都有效,而且本来也会继续保持有效,因此什么也不做。
- @middle_valid == 1,且 @will_update_dout == 1:@middle_dout 有效,并将被复制到 @dout。因此需要用 @fifo_dout 来更新 @middle_dout,让它继续保持有效。
注意,当 @middle_valid 和 @fifo_valid 同时为高时,@fifo_rd_en 为低。因此,在上述后两种情况下,不会从 orig_fifo 获取新数据。
具体来说,当两级流水线都有效且 @rd_en 为高时,@fifo_dout 的值会被复制到 @middle_dout。同时由于 @fifo_rd_en 为低,@fifo_valid 会在下一个时钟周期变为低。这没什么问题,因为 @middle_valid 仍会保持为高,如果需要,它可以在接下来的这个时钟周期提供数据。再下一个时钟周期,@fifo_valid 会重新变高(前提是 orig_fifo 中还有数据)。
那么,为什么不在这种特定情况下让 @fifo_rd_en 继续保持 @fifo_dout 有效呢?因为那样的话,@fifo_rd_en 就必须成为 @rd_en 的组合逻辑函数,而这恰恰是使用这条两级流水线想要避免的。
有了这些基础,现在可以来看 @dout 是如何定义的了。除复位之外,定义如下:
always @(posedge rd_clk)
  if (will_update_dout)
    dout <= middle_valid ? middle_dout : fifo_dout;
把 @will_update_dout 替换成它的定义,就变成:
always @(posedge rd_clk)
  if (rd_en && !empty)
    dout <= middle_valid ? middle_dout : fifo_dout;
这和把 FWFT FIFO 转换为“标准 FIFO”的代码很相似,区别只是这里有两个可选的数据来源:如果 @middle_dout 中有有效值,就取它;否则取 @fifo_dout。如果两者都无效,那么 @empty(空)为高,反正什么都不会发生。
这为什么有帮助?就输出时序而言,@dout 显然是寄存器输出。再看 @rd_en:请注意,@fifo_rd_en 只依赖于 @middle_valid 和 @fifo_valid,而这两个都是寄存器;此外还依赖于 @fifo_empty,而它是 orig_fifo 自身的输出(这条组合逻辑路径是不可避免的)。因此,@fifo_rd_en 不依赖于外部 @rd_en,也就是说从 @rd_en 到 orig_fifo 不存在组合逻辑路径。
跟踪流水线各级寄存器的有效性
为了让整个图景更加完整:这两个 *_valid 标志位告诉我们相关联的寄存器中是否含有有效数据。先看 @fifo_valid:
 if (fifo_rd_en)
   fifo_valid <= 1;
 else if (will_update_middle || will_update_dout)
   fifo_valid <= 0;
这和上面把“标准 FIFO”转换为 FWFT FIFO 时 @dout_valid 的定义类似:当某个时钟上升沿 @fifo_rd_en 为高时,@fifo_valid 随即变为高。这很合理——如果从 orig_fifo 读出了数据,该 FIFO 的输出自然应当被视为有效。但如果 @fifo_rd_en 为低,而数据被复制到了 @middle_dout 或 @dout 中,那就不再认为 @fifo_dout 有效:该 FIFO 的输出刚刚被使用,而 FIFO 没有用新数据替换它。
@middle_valid 遵循同样的逻辑:
 if (will_update_middle)
   middle_valid <= 1;
 else if (will_update_dout)
   middle_valid <= 0;
当 @will_update_middle 为高时,数据被复制到 @middle_dout,因此 @middle_valid 也随之变为高。否则,如果 @middle_dout 中的数据被复制到 @dout,@middle_valid 就变为低。@will_update_dout 是这种情况的充分条件,因为前面说过,只要有可能,@dout 会优先从 @middle_dout 取值复制。
这真的能正常工作吗?
这个模块太复杂了,几乎需要一套形式化的证明来确认它能工作。因此,一种回答这个问题的方式,是看 @fifo_dout 和 @middle_dout 这两级流水线中到底有多少级是有效的。这个值并没有在 reg_fifo 模块中定义,但它本来可以被定义为
wire [1:0] valid_count;
assign valid_count = fifo_valid + middle_valid;
这个假想的 @valid_count 显然可以取值 0、1 或 2。它的递增或递减规则如下:
- @valid_count 在每个满足以下条件的时钟周期加一:@fifo_rd_en 为高,且 (rd_en && !empty) 为假。
- @valid_count 在每个满足以下条件的时钟周期减一:@fifo_rd_en 为低,且 (rd_en && !empty) 为真。
- 否则,@valid_count 保持不变。
请对照前面的逻辑方程看一看,并自行确认这三条结论是正确的。
下面来看:当 orig_fifo 中有数据,而应用逻辑希望连续读取时,会发生什么:
reg_fifo 的逻辑试图通过从 orig_fifo 读取数据,把 @valid_count 推向 2。另一方面,当 @valid_count 不为 0 时,@empty(空)为低,因此一旦 @valid_count 等于 1,@rd_en 就可以变为高。所以,当 @valid_count 为 1 时,由于它不等于 2,@fifo_rd_en 会保持为高。
但 @valid_count 不会到达 2,因为 @rd_en 一直为高,阻止了它继续上升。于是数据以 @fifo_rd_en 和 @rd_en 同时保持为高的方式流动,而 @valid_count 则维持在 1。除最开始的一小段外,数据都是直接从 @fifo_dout 复制到 @dout 的。
这种均衡在 orig_fifo 变 empty(空)时会被打破:此时由于 @fifo_rd_en 不再允许为高,@valid_count 会降为 0。另一个打破均衡的情况是:FIFO 不空,但应用逻辑不想继续读取,于是 @rd_en 变低。这时,@valid_count 会上升到 2,并保持在该值。
但之后当 @rd_en 重新变高时,@valid_count 会降到 1,直到此时 @fifo_rd_en 才会变高(除非 orig_fifo 是 empty(空))。
再说一次,@valid_count 只是一个理论上的信号,在模块中并没有实际实现。希望上面的解释能帮助你理解:为什么额外增加的两级流水线就能保证数据连续流动。
使用说明
这个模块可以直接替换它所包装的“标准 FIFO”,在功能上没有任何变化。不过,orig_fifo 所看到的 @rd_en、@dout 和 @empty(空)行为会略有不同,但只要 orig_fifo 作为 FIFO 的行为是正确的(这一点完全可以放心),就不会有任何问题。与写入数据有关的端口都是原样透传的,所以这些端口不会受到任何影响。
由于这个模块增加了几级流水线,orig_fifo 的填充计数器(fill counter)显示的数值可能会低于 reg_fifo 中实际存储的数据字总数(也就是 orig_fifo 中存储的数据字与流水线各级中数据字的总和)。因此,如果在 orig_fifo 上启用了 @almost_empty(几乎空)或类似端口,它们给出的情况可能会偏悲观。
reg_fifo 有一个小缺点:它的 @empty(空)输出并不是寄存器输出,而是两个寄存器的组合逻辑函数。这对时序来说不是最优的,但在大多数使用场景中影响很小。这个问题可以通过定义一些组合逻辑信号(供寄存器使用)来解决,例如按照那一页中 @next_words_in_ram 的同样思路,定义 @next_fifo_valid 和 @next_middle_valid。这里没有这样实现,主要是因为 reg_fifo 本身已经够复杂了。
时序得到改善的 FWFT FIFO
如果需要的是一个时序得到改善的 FWFT FIFO,那就很简单:使用上面 basic_fwft_fifo 的例子,但把其中对普通 FIFO 的实例化换成 reg_fifo。这样会额外需要一个寄存器,不过这点代价是值得的。
至此,本系列关于 FIFO 的全部内容就结束了。